Нейросеть по документам — это когда вы загружаете свои файлы (договор, инструкцию, регламент, базу знаний) и задаёте вопросы, а модель отвечает по их тексту и показывает, откуда взяла ответ. Технология называется RAG. Мы собрали такую систему у себя на сервере из бесплатных программ — Open WebUI и Ollama, без интернета и облаков, — и проверили на договоре аренды. Ниже — что такое RAG простыми словами, как это настроить и чего ждать от обычного компьютера без видеокарты.
Что такое RAG (retrieval augmented generation)
Retrieval augmented generation — «генерация, дополненная поиском». Термин ввели исследователи Facebook AI в статье 2020 года. Идея простая: языковая модель не знает ваших документов и при вопросе о них начинает угадывать. Поэтому перед ответом система сама ищет в документах подходящие куски и подкладывает их модели вместе с вопросом. Модель отвечает уже по тексту, а не «из головы».
Как устроена RAG-система по шагам:
- Нарезка. Документ делится на небольшие фрагменты (чанки).
- Эмбеддинги. Отдельная модель превращает каждый фрагмент в набор чисел — «смысловой отпечаток». Отпечатки складываются в векторную базу.
- Поиск. Вопрос тоже превращается в отпечаток, и система находит фрагменты с самым близким смыслом — даже если слова в вопросе и документе разные.
- Ответ. Найденные фрагменты и вопрос отправляются языковой модели, она пишет ответ и ставит ссылки на источники.
Отсюда главное достоинство RAG: ответы можно проверить, а модель не нужно дообучать — достаточно загрузить файлы.
Нейросеть для анализа документов у себя на сервере
Для теста мы взяли:
- Ollama 0.34.4 — запускает модели локально;
- bge-m3 — модель эмбеддингов, по описанию в библиотеке Ollama, многоязычная, 567 млн параметров, 1,2 ГБ:
ollama pull bge-m3; - qwen2.5:3b — небольшая языковая модель, 1,9 ГБ:
ollama pull qwen2.5:3b; - Open WebUI 0.12.2 — веб-интерфейс с базами знаний.
Open WebUI запускали в Docker с переменными, которые говорят ему брать эмбеддинги из Ollama:
docker run -d --name open-webui --network host \
  -e PORT=3001 \
  -e OLLAMA_BASE_URL=http://127.0.0.1:11434 \
  -e RAG_EMBEDDING_ENGINE=ollama \
  -e RAG_EMBEDDING_MODEL=bge-m3 \
  -v open-webui:/app/backend/data \
  ghcr.io/open-webui/open-webui:main
Модель эмбеддингов лучше выбрать сразу. По документации Open WebUI, после её смены все документы в базах знаний нужно переиндексировать: отпечатки разных моделей несовместимы, и поиск по старым даст ерунду.
Как загрузить документы
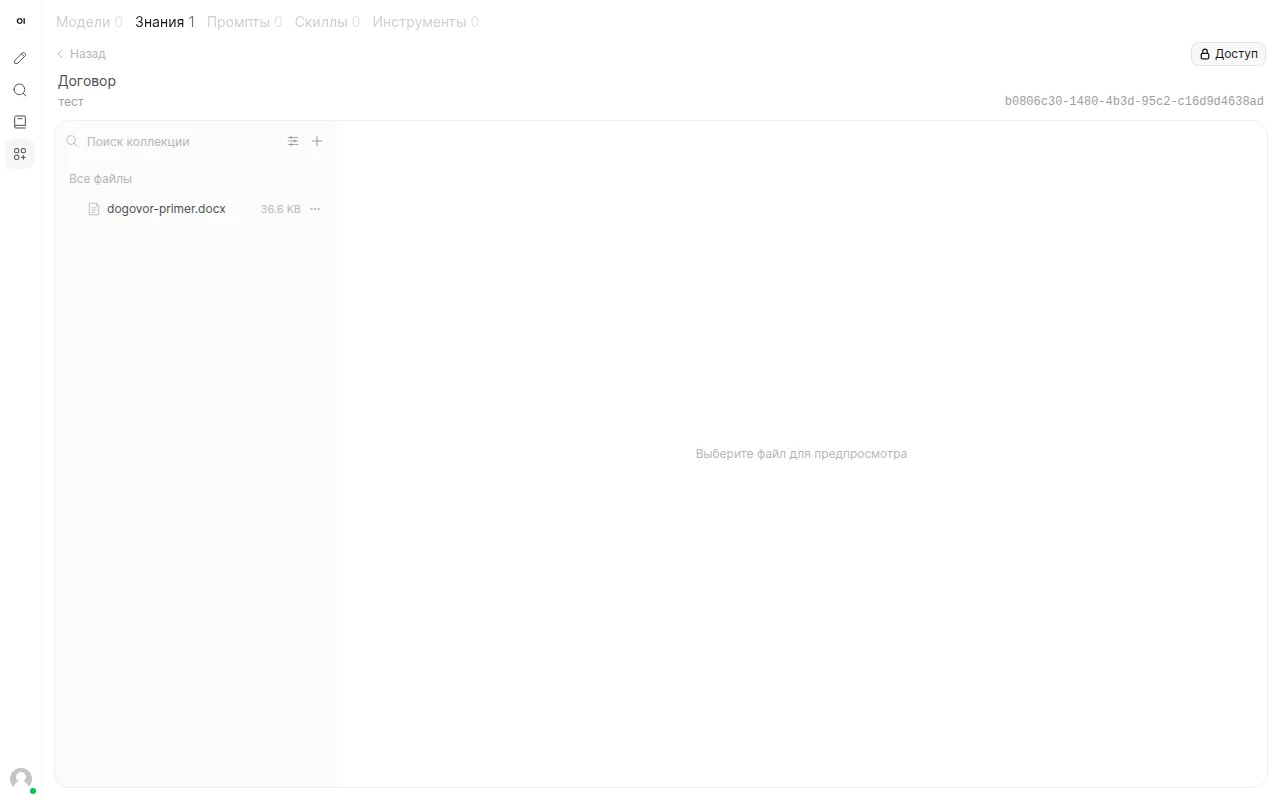
В Open WebUI: Рабочее пространство → Знания → создать коллекцию и добавить файлы. Поддерживаются Word, PDF, текст и другие форматы. Дальше в чате наберите # и выберите коллекцию — вопрос будет искать ответ в ней. Коллекцию можно и привязать к модели насовсем, чтобы не выбирать каждый раз.
Ответ по документу: наш тест
Мы сделали учебный документ Word — «Договор аренды квартиры» из 8 пунктов с выдуманными условиями (адрес, сумма, сроки — всё ненастоящее). Индексация заняла около 30 секунд. Затем задали вопросы:
| Вопрос | Ответ модели с RAG |
|---|---|
| Какой размер арендной платы и до какого числа её платить? | «Арендная плата составляет 38 500 рублей в месяц и вносится не позднее 5 числа текущего месяца переводом на карту Арендодателя [1]» |
| Можно ли завести кошку? | «…проживание с домашними животными допускается только с письменного согласия Арендодателя [5]. Поэтому вам нужно будет получить у Арендодателя письменное согласие…» |
| За сколько дней нужно предупредить о расторжении договора? | «…не менее чем за 30 дней [1]» |
Все три ответа совпали с текстом договора, у каждого — ссылка на документ. Обратите внимание на вопрос про кошку: в договоре слова «кошка» нет, есть «домашние животные», и поиск по смыслу всё равно нашёл нужный пункт.
Без базы знаний та же модель на вопрос «можно ли завести кошку по моему договору и сколько я плачу» честно ответила, что не знает условий договора, и посоветовала заглянуть в него. Это лучший случай: модели покрупнее и «поувереннее» в такой ситуации нередко выдумывают ответ.
Грабля: на процессоре это медленно
Тестовый сервер — 4 ядра и 16 ГБ памяти, без видеокарты. Каждый ответ с RAG занял от 4 до 6 минут. Причина в том, что Open WebUI перед ответом делает несколько обращений к модели — например, сам формулирует поисковые запросы, — и всё это на процессоре. Сначала мы взяли «думающую» модель qwen3:4b, и она рассуждала по 800 с лишним токенов на скорости около 4 токенов в секунду — ответа не дождались. Модель без режима рассуждений справилась.
Вывод: для удобной работы нужна видеокарта или хотя бы мощный процессор; на слабом сервере выбирайте маленькую модель без рассуждений. Сколько тянет домашнее железо, мы разбирали в статье про Ollama.
Нейросеть по документам Word и PDF: что учесть
- Сканы. RAG работает с текстом. Если PDF — это картинки страниц, сначала распознайте текст: как это сделать, в статье про распознавание текста.
- Таблицы и сложная вёрстка разбираются хуже простого текста — проверяйте ответы по ссылкам на источник.
- Ссылки на источник — не украшение: модель может ошибиться, а цитата позволяет быстро сверить ответ.
- Конфиденциальность. Локальная система не отправляет документы в чужое облако — это главный довод собирать её у себя. Если же использовать облачные модели (например, GigaChat API), фрагменты документов уходят провайдеру.
- Доступ. Не открывайте Open WebUI в интернет без пароля и HTTPS.
Источники: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (arXiv), Open WebUI: RAG, Open WebUI: базы знаний, bge-m3 в Ollama. Тест — Open WebUI 0.12.2, Ollama 0.34.4, модели qwen2.5:3b и bge-m3 на сервере с 4 ядрами без видеокарты. Проверено 15 октября 2026 года.