LM Studio — программа для запуска нейросетей на своём компьютере, скачать её можно бесплатно: скачиваете модель в один клик, разговариваете с ней в окне, как в ChatGPT, а при желании включаете локальный сервер с API. Мы поставили LM Studio на обычный рабочий ПК со слабой видеокартой и замерили, с какой скоростью там работают две популярные модели. В статье — как скачать и установить программу, какую модель выбрать, наши цифры, сервер и API, новое приложение Bionic и сравнение с Ollama.
Что такое LM Studio
Это настольное приложение для Windows, macOS и Linux от компании Element Labs. Внутри — движок llama.cpp, тот же, на котором работает большинство локальных запусков моделей, а снаружи — понятный интерфейс: каталог моделей, чат, настройки и кнопка запуска сервера. Модели берутся с Hugging Face в формате GGUF, на Mac — ещё и в формате MLX.
Главное отличие от облачных чатов: модель лежит у вас на диске, запросы никуда не уходят, интернет после загрузки модели не нужен. Платить за токены не надо — платите видеокартой, памятью и временем ожидания.
По условиям использования программа лицензируется для личных задач и внутренних задач компании. Перепродавать её как сервис нельзя, а отдельные облачные функции платные.
Системные требования
По документации LM Studio:
- Windows — процессор x64 с поддержкой инструкций AVX2 или ARM (Snapdragon X Elite), рекомендуется от 16 ГБ памяти и от 4 ГБ видеопамяти;
- macOS — только Apple Silicon (M1 и новее), macOS 14 и выше, рекомендуется от 16 ГБ памяти; маки на Intel не поддерживаются;
- Linux — x64 или ARM64, программа распространяется как AppImage, официально — Ubuntu 20.04 и новее.
Как скачать и установить LM Studio
- Скачайте установщик с официального сайта
lmstudio.ai— на 17 октября 2026 года актуальна версия 0.4.25. Для Windows установщик весит около 620 МБ. - Запустите его и пройдите установку — она занимает пару минут.
- При первом запуске программа предложит скачать стартовую модель. Можно согласиться или выбрать свою во вкладке поиска моделей.
Скачивать программу стоит только с официального сайта: перед установкой мы проверили цифровую подпись — установщик подписан компанией Element Labs.
Вместе с программой ставится консольная утилита lms. Она умеет всё то же, что и окно: lms get скачивает модель, lms load загружает её в память, lms server start включает сервер, lms ps показывает, что сейчас загружено.
Модели для LM Studio: какую выбрать
Правило простое: файл модели должен целиком помещаться в память. Если есть видеокарта, быстрее всего, когда модель влезает в видеопамять. Если нет — модель работает на процессоре из обычной памяти, но заметно медленнее.
Ориентир по размеру для 4-битных сборок (Q4_K_M — самый частый выбор):
| Модель | Параметров | Размер файла | Кому подойдёт |
|---|---|---|---|
| Gemma 4 E4B | 7,5 млрд | 6,3 ГБ | ПК с 16 ГБ памяти, ноутбуки |
| Qwen 3.5 9B | 9 млрд | 6,6 ГБ | ПК с 16 ГБ памяти и больше |
Размеры — то, что показала сама LM Studio после загрузки; в них входит и вспомогательный файл для работы с картинками. Модели крупнее, на 20–30 млрд параметров, разумно запускать только с видеокартой на 16–24 ГБ — как, например, Qwen 3.8 27B, которую мы разбирали в видеоразборе.
Наш тест: LM Studio без мощной видеокарты
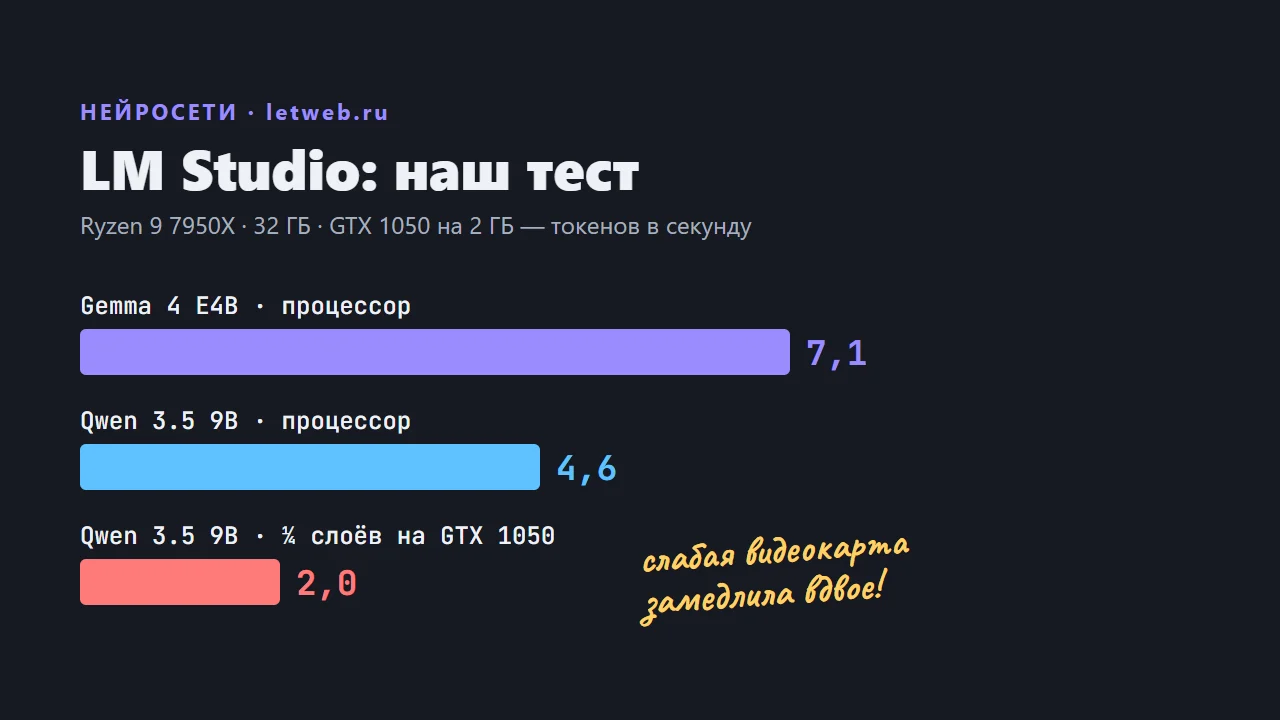
Компьютер: процессор AMD Ryzen 9 7950X (16 ядер), 32 ГБ памяти, видеокарта NVIDIA GeForce GTX 1050 с 2 ГБ памяти — то есть видеопамяти вдвое меньше рекомендованного. Задание одно: «Объясни простыми словами, что такое DNS и зачем нужна A-запись», ответ до 400 токенов, по два прогона на каждую настройку.
| Модель и настройка | Скорость ответа | 400 токенов за |
|---|---|---|
| Gemma 4 E4B, только процессор | 7,1 токена в секунду | 56–64 с |
| Qwen 3.5 9B, только процессор | 4,6 токена в секунду | 87–96 с |
| Qwen 3.5 9B, четверть слоёв на видеокарте | 1,8–2,1 токена в секунду | 190–221 с |
Три вывода из замера.
Слабая видеокарта может замедлить. Когда мы отдали четверть слоёв модели на GTX 1050, скорость упала вдвое: видеопамять заполнилась на 1,7 ГБ из 2, и данные постоянно гонялись между картой и процессором. На компьютере с небольшой видеокартой ставьте в настройках модели выгрузку на GPU в ноль и сравните — может оказаться быстрее.
Современные модели долго думают. В обоих случаях первые 400 токенов ушли целиком на «размышления», и до ответа дело не дошло. Когда мы дали Gemma 1 500 токенов, она потратила 424 токена на рассуждения и 182 — на сам ответ, а всё вместе заняло 86 секунд. Ответ получился толковым:
«Представьте, что DNS — это огромная телефонная книга интернета… A-запись — это конкретная запись в этой книге, которая напрямую связывает доменное имя с IPv4-адресом».
Если скорость важнее глубины, ищите в настройках модели переключатель рассуждений и выключайте его для простых задач.
Без видеокарты жить можно. 5–7 токенов в секунду — это примерно скорость чтения: для переписки, черновиков и вопросов по документам хватает, для генерации длинного кода — уже утомительно.
Наш результат относится к нашему компьютеру и этим двум моделям. На видеокарте, в которую модель помещается целиком, скорость вырастает в разы.
Сервер LM Studio и API
LM Studio умеет работать как локальный сервер, совместимый с API OpenAI. Это значит, что программы, написанные под ChatGPT, можно переключить на локальную модель сменой адреса. Включается сервер во вкладке разработчика или командой:
lms server start
По умолчанию сервер слушает порт 1234, базовый адрес — http://localhost:1234/v1. Поддерживаются запросы к чату (/v1/chat/completions), Responses API, эмбеддинги и список моделей. Пример запроса:
curl http://localhost:1234/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "google/gemma-4-e4b",
       "messages": [{"role": "user", "content": "Что такое A-запись?"}]}'
У нас GET /v1/models вернул список загруженных и скачанных моделей, а запросы к чату отработали с теми же цифрами, что в таблице выше. Так же к LM Studio подключаются интерфейсы вроде Open WebUI и редакторы кода.
LM Studio Bionic
В июле 2026 года та же команда выпустила отдельное приложение — LM Studio Bionic. Это не замена LM Studio, а агент поверх неё: умеет работать с кодом (показывает правки, ищет по проекту), с документами (PDF, презентации, таблицы — в изолированной среде) и принимает голосовой ввод через офлайн-модель распознавания речи. Модели Bionic берёт из той же библиотеки, что и LM Studio, так что дважды их качать не надо. Запускать их можно локально, с другого своего устройства или через облако LM Studio — облачный вариант платный и требует аккаунта.
LM Studio или Ollama
| LM Studio | Ollama | |
|---|---|---|
| Интерфейс | Полноценное окно: каталог, чат, настройки | В основном командная строка и API |
| Порог входа | Ниже: всё мышкой | Выше, но команды простые |
| Сервер и API | Порт 1234, совместим с OpenAI | Порт 11434, свой API и совместимый с OpenAI |
| На сервер без монитора | Есть режим без окна, но программа настольная | Создана для этого |
| Лицензия | Лицензия на личное и внутреннее использование, отдельные функции платные | Открытый код |
Для знакомства с локальными моделями на своём компьютере удобнее LM Studio. Для домашнего сервера и автоматизации — Ollama: про неё у нас отдельная статья «Ollama: локальная нейросеть на ПК».
Частые проблемы
- Модель качается очень медленно. Загрузка идёт с Hugging Face. У нас встроенная загрузка шла со скоростью меньше мегабайта в секунду; файл можно скачать вручную по прямой ссылке со страницы модели и положить в папку моделей LM Studio (по умолчанию
C:\Users\<имя>\.lmstudio\models, внутри — папка автора и папка модели). - LM Studio не видит модель. В нашем случае модель с поддержкой картинок не появлялась в списке, пока рядом с основным файлом не оказался вспомогательный файл
mmproj-…ggufиз того же репозитория. Если качаете вручную — берите оба файла. - Не удалось загрузить модель. Чаще всего не хватает памяти: уменьшите длину контекста в настройках загрузки или возьмите модель меньше.
Документация: системные требования LM Studio, API, совместимый с OpenAI, утилита lms, LM Studio Bionic, условия использования, заметки к версии 0.4.25. Замеры сделаны 17 октября 2026 года. Проверено 17 октября 2026 года.