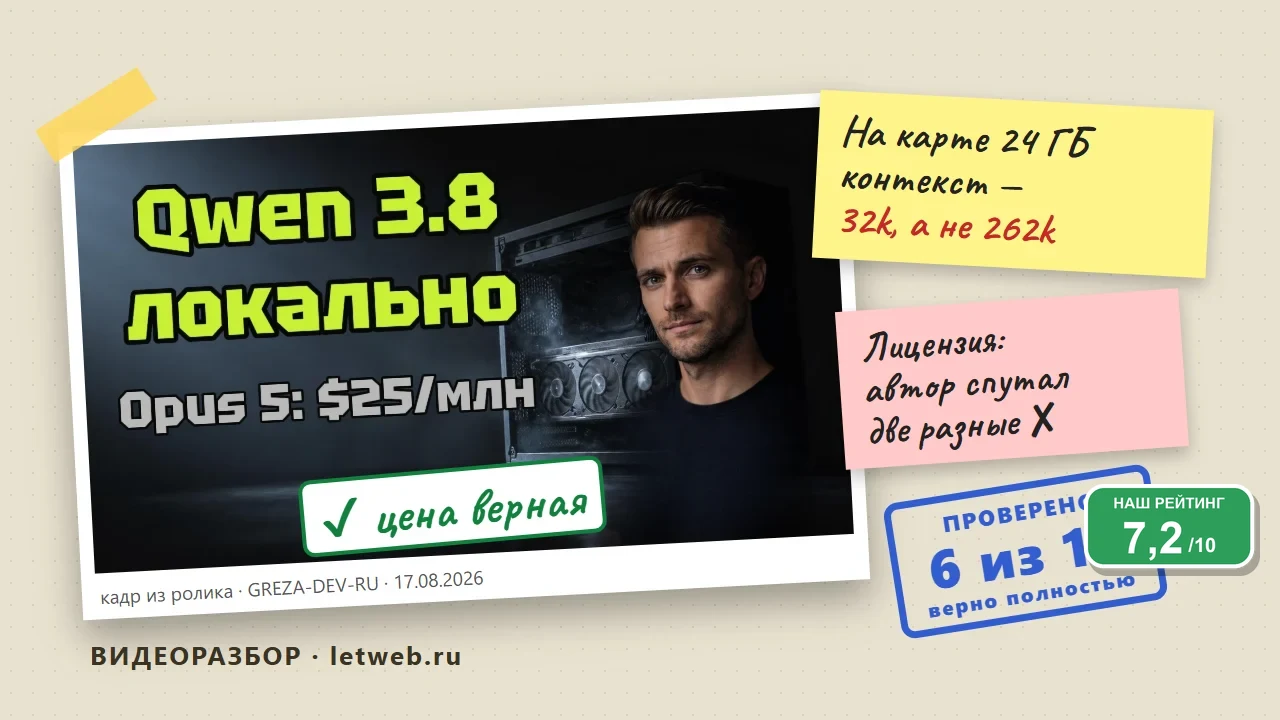
Qwen 3.8 27B — открытая модель Alibaba, которую можно запустить локально на одной видеокарте. Про неё вышел ролик «Qwen 3.8 27B: одна команда — и вы больше не платите за токены» (канал GREZA-DEV-RU, 17 августа 2026 года, 11 минут). Мы посмотрели его и сверили каждое проверяемое утверждение с первоисточниками: карточками моделей на Hugging Face, библиотекой Ollama, документацией vLLM и прайсом Anthropic. Коротко: ролик аккуратнее собственного заголовка, большинство цифр подтверждается, а главная ошибка — в финале про лицензию.
О чём видео
Первая минута — про экономику: облачная модель берёт деньги за каждый миллион токенов, локальная лежит на диске и ничего не стоит до запроса. Дальше — установка одной командой в Ollama, скорость на домашней видеокарте и локальный адрес, на который переключается свой код. Вторая половина полезнее первой: автор сам разбирает, где обещание из заголовка не выдерживает проверки — флагман семейства домашней карте не по силам, бенчмарки считал сам разработчик, а заявленное окно контекста на карте с 24 ГБ недостижимо.
Плеер YouTube загрузится после нажатия. Не открывается — смотрите ролик на YouTube.
Проверка фактов
| Утверждение из видео | Вердикт | Чем проверено |
|---|---|---|
| Claude Opus 5 — 5 и 25 долларов за миллион токенов на входе и выходе, Sonnet 5 — 2 и 10, Haiku 4.5 — 1 доллар на входе | Верно | Прайс Anthropic: Opus 5 — $5 / $25, Sonnet 5 — $2 / $10, Haiku 4.5 — $1 / $5 |
| Установка одной командой в Ollama, первая загрузка около 18 ГБ | Верно | Библиотека Ollama: ollama run qwen3.8, тег qwen3.8:27b — 18 ГБ |
| Открытые веса флагмана — только текст, без картинок и без окна в миллион токенов | Верно | Карточка Qwen3.8-2.4T-A95B: текстовая модель, изображения не поддерживаются; зрение и 1M контекста — у облачной Qwen3.8-Max |
| Флагманский результат на Terminal-Bench снят в харнессе Claude по десяти запускам, а цифры конкурентов взяты из других харнессов | Верно | Сноска к таблице в карточке флагмана: Claude Code, avg@10; для остальных — «лучший опубликованный результат среди харнессов» |
| Уровень усилия рассуждения по умолчанию — самый дорогой | Верно | Карточка 27B: reasoning_effort — xhigh по умолчанию, есть medium и low |
| Режим размышления — температура 1,0 и top_p 0,95; режим инструкций — 0,7 и 0,8; presence penalty 1,5 | Верно, с уточнением | Карточка 27B. Уточнение: presence_penalty=1.5 — только для режима без размышления, в режиме размышления он 0 |
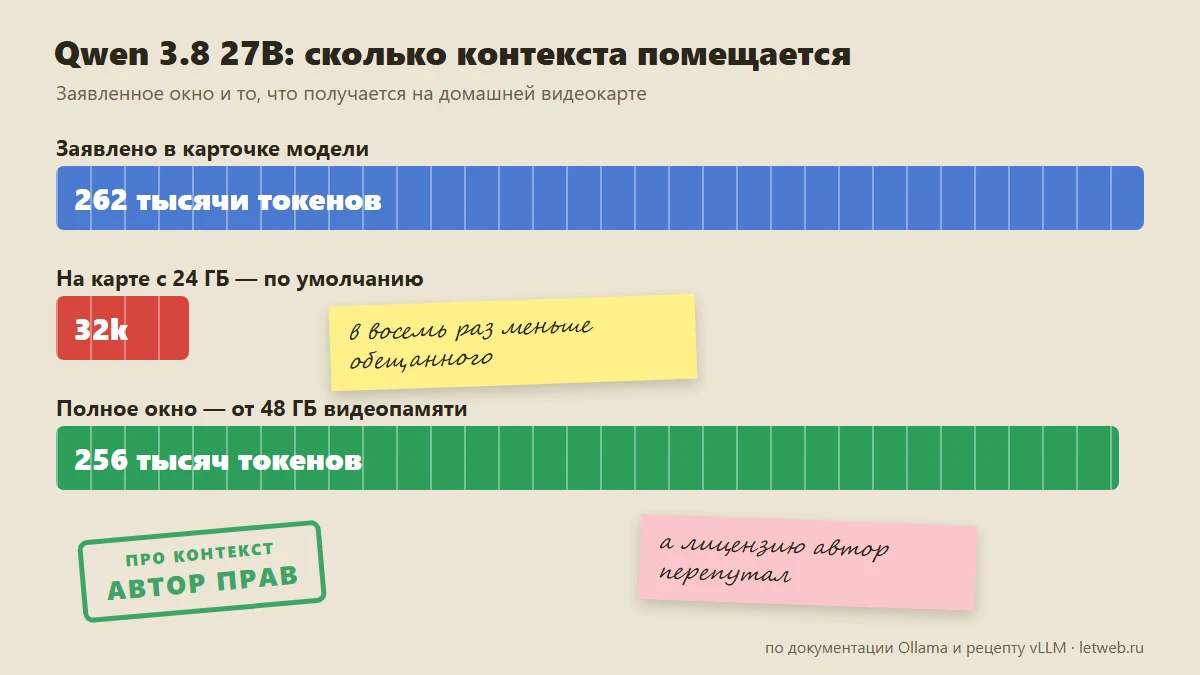
| Заявленные 262 тысячи токенов контекста на карте с 24 ГБ превращаются примерно в 32 тысячи | В основном верно | Документация Ollama: при 24–48 ГБ видеопамяти контекст по умолчанию 32k, 256k — от 48 ГБ. Рецепт vLLM для одной RTX 5090 тоже запускает модель с окном 32 768 |
| Удержание всего окна потребует 60–80 ГБ | Не проверено | В документации такой цифры нет. Объём зависит от сборки и точности KV-кэша |
| Скорость 10–160 токенов в секунду; у автора на RTX 4090 — 85–95 | Не проверено | Собственные замеры автора. Спекулятивное декодирование (MTP) у модели действительно есть — карточка и рецепт vLLM |
| Все числа бенчмарков — собственный прогон Alibaba, часть тестов компания построила сама | В основном верно | В карточке есть собственный тест QwenSWEBench («in-house»); оценки получены командой Qwen. Что независимых замеров нет вовсе — не проверяли |
| На железе NVIDIA сборка MXFP4 в vLLM не загрузится, нужна NVFP4 | Не подтверждено | Рецепт vLLM описывает сборки NVFP4 и FP8 и про MXFP4 не говорит ничего |
| Модель выходит под Apache 2.0, и это «краткая версия» условий с порогами по выручке и аудитории | Неверно | Это две разные лицензии — см. ниже |
Что подтвердилось
Цены Anthropic автор назвал точно — на них строится вся экономика ролика. Установка действительно сводится к одной команде:
ollama run qwen3.8
Команда взята из библиотеки Ollama; мы её для этой статьи не запускали. Тег qwen3.8:27b весит 18 ГБ, принимает текст и изображения, заявленное окно — 256K. Как работает Ollama и локальный адрес на порту 11434, мы разбирали в статье «Ollama: локальная нейросеть на ПК».
Самое ценное наблюдение ролика — про бенчмарки — тоже подтверждается документом самого разработчика. В сноске к таблице флагмана написано, что Terminal Bench 2.1 для Qwen считали в Claude Code со средним по десяти запускам, а для остальных моделей взяли лучший опубликованный результат «across harnesses». То есть в одной строке стоят числа, полученные в разной обвязке. Харнесс задаёт число попыток, тайм-ауты и формат вызова инструментов, поэтому такие числа сравнивать напрямую нельзя. Что такое харнесс и зачем он нужен, мы показывали на примере DeepSeek Harness.
Qwen 3.8 27B локально: сколько контекста на самом деле
В карточке модели указано окно 262 144 токена, расширяемое до миллиона. Это свойство весов. Сколько из него достанется вам, зависит от видеопамяти: кроме самих весов в ней лежит KV-кэш, который растёт с каждым удержанным токеном.
Документация Ollama называет значения по умолчанию прямо: до 24 ГБ видеопамяти — 4k контекста, от 24 до 48 ГБ — 32k, от 48 ГБ — 256k. Изменить можно переменной OLLAMA_CONTEXT_LENGTH, но большее окно требует больше памяти. Рецепт vLLM для одной RTX 5090 (32 ГБ) запускает модель с --max-model-len 32768. Так что цифра автора «около 32 тысяч на карте с 24 ГБ» совпадает с тем, что пишут сами разработчики инструментов. А вот «60–80 ГБ на всё окно» — оценка автора, в документации её нет.
Где видео ошибается: лицензия
В финале автор перечисляет условия — показывать название модели после 100 миллионов пользователей в месяц или 20 миллионов долларов выручки, отдельная лицензия после 50 миллионов долларов выручки за 12 месяцев — и подытоживает: модель выходит под Apache 2.0. Это смешение двух разных лицензий.
- Qwen3.8-27B — Apache 2.0. В тексте этой лицензии нет порогов по выручке и аудитории.
- Qwen3.8-2.4T-A95B (флагман) — собственная лицензия Qwen3.8-Max License. Пороги — из неё: название модели нужно показывать в интерфейсе при 100 миллионах активных пользователей в месяц или 20 миллионах долларов месячной выручки; отдельная лицензия нужна тем, кто ведёт бизнес «модель как сервис» или «ИИ-ассистент для работы» с выручкой больше 50 миллионов долларов за 12 месяцев.
Для модели, которую ставят на домашнюю карту, действует простая Apache 2.0. Условия с порогами относятся к флагману, и перед коммерческим использованием читать нужно файл LICENSE в его репозитории, а не пересказ.
Что не удалось проверить
- Скорость 85–95 токенов в секунду на RTX 4090 и 160 на NVIDIA DGX Spark — замеры автора, официальных таблиц скорости в карточке нет. Проверяется на своей карте за несколько минут.
- Ответы «от 20 до 90 минут» на простые запросы — сообщения пользователей. Причина при этом реальная: по умолчанию стоит максимальный уровень рассуждения. В карточке есть и встречное предупреждение: в многошаговых задачах низкий уровень не всегда быстрее, потому что растёт число ошибок и повторов.
- Запрет MXFP4 в vLLM на картах NVIDIA — в рецепте vLLM такого утверждения нет.
Вывод
Ролик стоит посмотреть: из двенадцати проверенных утверждений шесть полностью подтверждаются документацией, два верны в основном, два проверить не удалось, одно не подтвердилось и одно ошибочно. Практическая часть честная: автор сам показывает, что флагман из заголовка — не для домашней карты, а таблицы бенчмарков нельзя читать как независимое измерение. Не опирайтесь на ролик в двух местах: в вопросе лицензии и в точных гигабайтах под контекст. И помните вывод самого автора: счётчика токенов больше нет, но драйверы, шум, электричество и обновления теперь ваши.
Ещё одна открытая модель из Китая — в разборе «Kimi K3: разбор видео и проверка фактов».
Источники: карточка Qwen3.8-27B и карточка Qwen3.8-2.4T-A95B на Hugging Face, Qwen3.8-Max License, Apache License 2.0, qwen3.8 в библиотеке Ollama, документация Ollama о длине контекста, рецепт vLLM для Qwen3.8-27B, цены Anthropic. Проверено 2 октября 2026 года.
Наши оценки
Как считаем. Достоверность — доля подтвердившихся утверждений; ключевые тезисы ролика весят втрое больше второстепенных, мнения не учитываются, а то, что проверить нечем, получает половину. Приём зрителей — доля лайков от просмотров и тон самых заметных комментариев. Итог наполовину состоит из достоверности, на треть — из пользы и на пятую часть — из честности подачи; если заголовок обещает то, чего в ролике нет, снимаем полтора балла, а если ложен главный тезис ролика, итог не поднимается выше 4.
Заголовок и содержание. Заголовок «больше не платите за токены» ролик сам же и разбирает: платить придётся железом, электричеством и своим временем.
Реклама и интерес автора. Прямой рекламы в ролике нет.
Что пишут зрители
На 2 октября 2026 года: 7 125 просмотров, 118 лайков (1,7%), комментариев — 52.
Просмотров и комментариев немного, лайков около 1,7%, тон скорее прохладный. Ругают оформление — чередование чёрных и белых экранов — и сам выбор сравнения: локальную модель, по мнению зрителя, честнее сравнивать с недорогими подписками, а не со старшей платной моделью.
Практики делятся своими цифрами: на карте с 24 ГБ получают от 96 до 180 тысяч токенов контекста при сжатии кеша — больше, чем 32 тысячи из ролика; мы это не проверяли. Другие пишут, что на длинных задачах модель ломается, а без видеокарты работает со скоростью 5–7 токенов в секунду.
Обсудим?
Запускаете ли вы модели локально — и какой контекст реально помещается на вашей карте?
Напишите в комментариях под статьёй — что думаете о ролике и о нашей проверке. Возражения с источником ценнее всего: если мы ошиблись, исправим и отметим правку в тексте. Если вы автор ролика и не согласны с разбором, пришлите ответ — опубликуем его здесь же без сокращений.