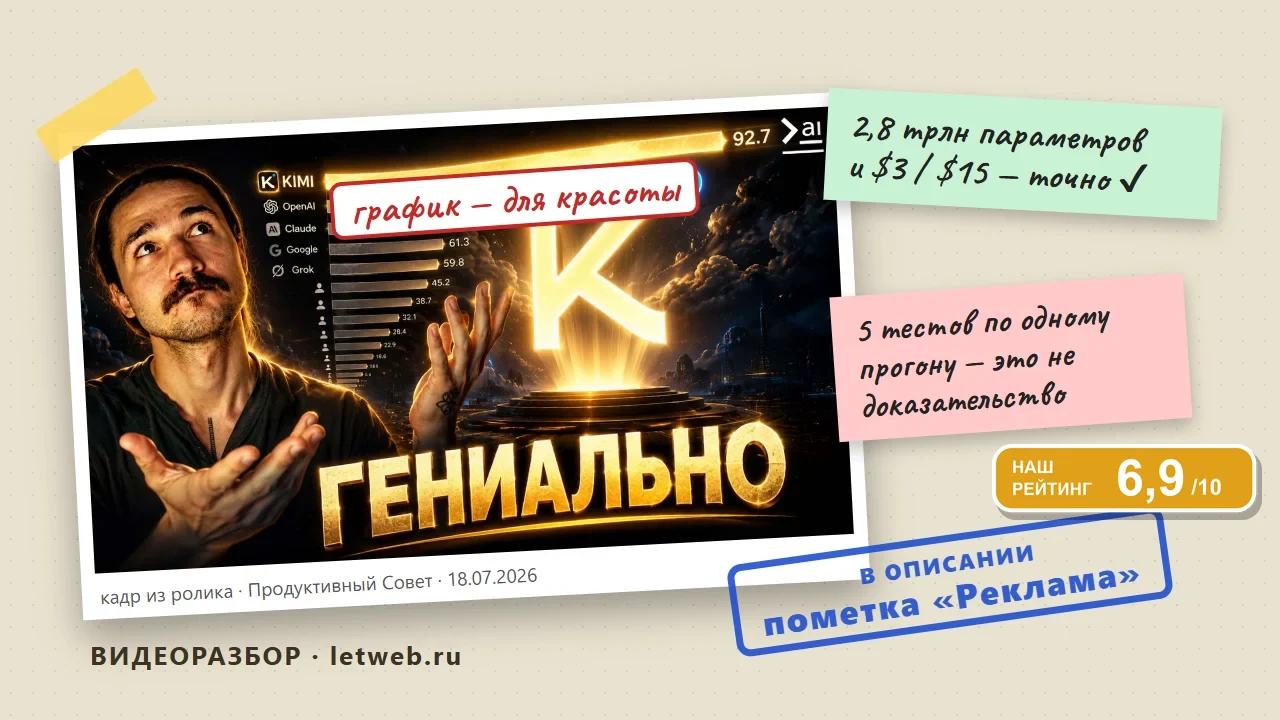
Kimi K3 — модель китайской компании Moonshot AI с открытыми весами, и ролик «Kimi K3 – Новая LLM, которая доказала, что опенсорс уже обогнал OpenAI и Anthropic. Или нет?» (канал «Продуктивный Совет», 18 июля 2026 года, 29 минут) пытается выяснить, догнали ли открытые модели закрытые. Мы сверили цифры ролика с карточкой модели на Hugging Face и прайсом Moonshot. Параметры и цены названы точно. А вот пять тестов, на которых построен вывод, сравнением моделей считать нельзя, и у ролика есть рекламная пометка.
О чём видео
Первая треть — вводная: чем закрытые модели отличаются от моделей с открытыми весами, почему китайским лабораториям труднее с вычислительными мощностями и как сокращается отставание открытых моделей. Дальше — цена Kimi K3 и пять практических тестов против других моделей: приложение для рисования, лендинг, сложная анимация, прототип игры и симуляция полёта в чёрную дыру. Итог автора осторожнее заголовка: открытые модели если не догнали лидеров, то «дышат в спину».
Плеер YouTube загрузится после нажатия. Не открывается — смотрите ролик на YouTube.
Проверка фактов
| Утверждение из видео | Вердикт | Чем проверено |
|---|---|---|
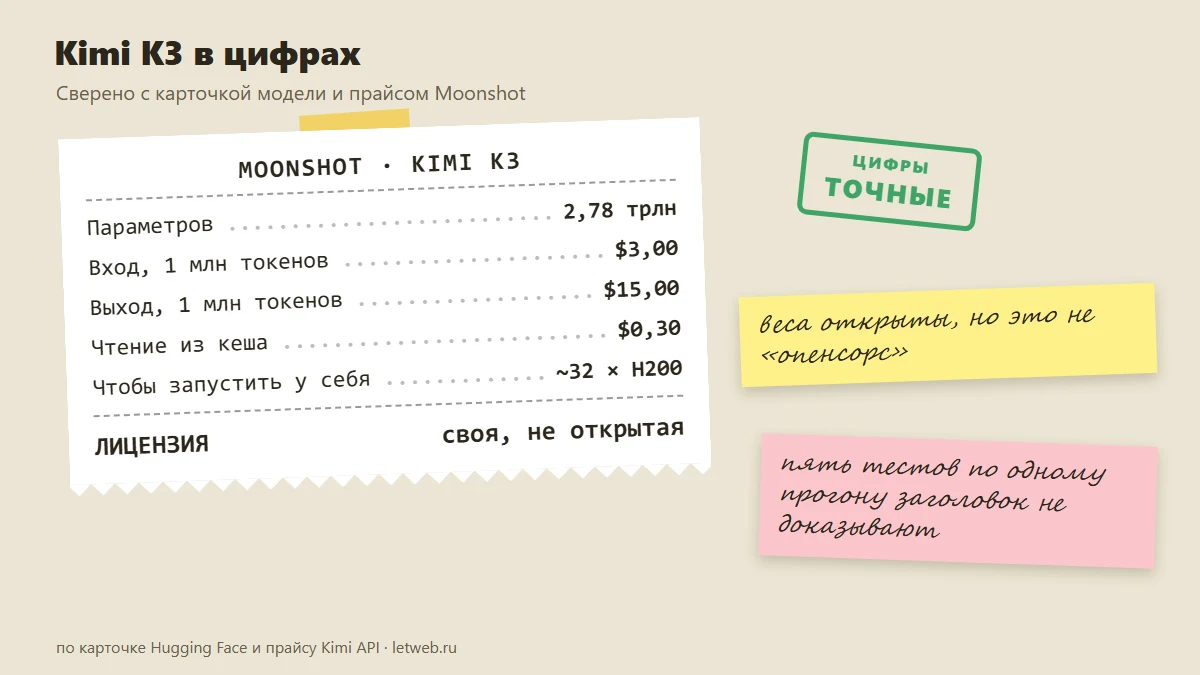
| Kimi K3 — 2,8 триллиона параметров | Верно | Hugging Face, репозиторий moonshotai/Kimi-K3: 2 779 931 837 184 параметра |
| Kimi K3 стоит 3 доллара за миллион входных токенов и 15 за миллион выходных | Верно | Прайс Kimi API Platform: модель kimi-k3 — $3,00 на входе, $15,00 на выходе, чтение из кеша $0,30 |
| Модель с открытым исходным кодом | С уточнением | Веса открыты, но лицензия собственная — Kimi K3 License, а не одна из стандартных открытых лицензий. Условия нужно читать в файле LICENSE |
| Для запуска нужно около трёх терабайт видеопамяти, примерно 32 ускорителя H200 и полтора миллиона долларов | Правдоподобно | Арифметика сходится с числом параметров; цену оборудования мы не проверяли |
| Fable 5 через классификаторы безопасности перекидывал запросы на другую модель, а пользователи думали, что говорят с флагманом | Механизм существует | Документация Claude Code описывает автоматическое переключение модели при срабатывании классификаторов. Что это происходило «молча», ролик не подтверждает |
| Результаты пяти тестов показывают, что открытые модели догнали закрытые | Не следует из тестов | Условия не выровнены — см. ниже |
| Отставание открытых моделей сократилось с семи месяцев до трёх-четырёх | Не проверено | Источник в ролике назван неточно, первоисточник мы не нашли |
| План за 19 долларов закончился за три объёмных запроса | Личный опыт | Без объёма задач и настроек проверить нельзя |
Kimi K3: почему тесты не доказывают заголовок
По рассказу самого автора, каждая модель работала в своей обвязке, одну запускали локально, результат ещё одной прислал другой человек со своей подписки и при этом добавил в задачу лишний контекст. Каждое задание прогоняли один раз, а оценивали на глаз. В таких условиях сравниваются не модели, а связки «модель плюс инструмент плюс удача одного запуска».
Это та же проблема, что и с таблицами разработчиков: результат зависит от обвязки не меньше, чем от модели. Мы разбирали её на примере другой открытой модели в статье «Qwen 3.8 27B локально: разбор видео и проверка фактов».
При этом автор ведёт себя честнее, чем можно ждать: в трёх тестах из пяти первое место он отдаёт не Kimi, цену называет разочарованием, а сам приводит довод против собственного тезиса — открытым моделям проще натренироваться на публичные тесты, поэтому реальный разрыв может быть больше измеренного.
Что ещё нужно знать
У ролика есть рекламная пометка. В описании стоит маркировка «Реклама» с идентификатором, а ссылки на продукт содержат партнёрские метки. В самой записи об этом не говорится. Это не обесценивает сказанное, но объясняет выбор темы.
«Открытая» не значит «запускается дома». Модель на 2,8 триллиона параметров требует оборудования уровня дата-центра. Для большинства читателей Kimi K3 — это облачный API по цене, сопоставимой с закрытыми моделями среднего класса: для сравнения, у Claude Sonnet 5 — 2 и 10 долларов за миллион токенов. Что реально запустить на своей видеокарте, мы показывали в статье про Ollama.
Цена за миллион токенов и счёт за задачу — разные вещи. Наблюдение автора о быстро закончившемся тарифе проверить нельзя, но направление верное: на агентных задачах с долгими рассуждениями расход определяется не прайсом, а тем, сколько токенов модель тратит на одну задачу.
Вывод
Цифры в ролике точные: число параметров и цены совпадают с карточкой модели и прайсом. Вывод из тестов — нет: пять разовых прогонов в разных условиях ничего не доказывают ни в одну сторону, и сам автор в финале формулирует мягче, чем в заголовке. Смотреть стоит ради вводной части и ради честных оговорок автора, помня о рекламной пометке. Если нужно выбрать модель для работы, проверяйте её на своей задаче и в одной и той же обвязке.
Про сервисы «все модели в одном окне» — разбор «ChatLLM от Abacus AI: все нейросети за $10».
Источники: карточка moonshotai/Kimi-K3 и Kimi K3 License на Hugging Face, цены Kimi API Platform, настройка моделей Claude Code, цены Anthropic. Проверено 2 октября 2026 года.
Наши оценки
Как считаем. Достоверность — доля подтвердившихся утверждений; ключевые тезисы ролика весят втрое больше второстепенных, мнения не учитываются, а то, что проверить нечем, получает половину. Приём зрителей — доля лайков от просмотров и тон самых заметных комментариев. Итог наполовину состоит из достоверности, на треть — из пользы и на пятую часть — из честности подачи; если заголовок обещает то, чего в ролике нет, снимаем полтора балла, а если ложен главный тезис ролика, итог не поднимается выше 4.
Заголовок и содержание. Вопрос «или нет?» в заголовке честный, ролик на него отвечает сдержанно. Неточность — слово «опенсорс»: открыты веса модели, а не исходные данные и код обучения.
Реклама и интерес автора. Размещение оплачено: стоит пометка о рекламе, ссылки на продукт партнёрские. При этом автор отдаёт первое место не заказчику в трёх тестах из пяти. В закрепе — собственные курсы и агентство канала.
Что пишут зрители
На 2 октября 2026 года: 110 056 просмотров, 2 477 лайков (2,3%), комментариев — 339.
Приём тёплый: больше 2% лайков, много благодарностей за нестандартные тесты. Самый залайканный комментарий иронизирует над итогом: начали с «зачем платить американцам», а закончили тем, что тариф за 19 долларов сгорел за три запроса.
Вторая по поддержке просьба — делать слепой тест, когда автор не знает, чью работу оценивает. Несколько зрителей поправляют заголовок: открытые веса — не открытый исходный код. Ещё пишут, что бесплатный доступ к модели на деле не работает из-за перегрузки, и что один из результатов заказчика объясняется готовой дизайн-системой, которой у соперника не было. Последнее мы не проверяли.
Обсудим?
Доверяете ли вы сравнениям моделей, если автор знает, чей ответ оценивает?
Напишите в комментариях под статьёй — что думаете о ролике и о нашей проверке. Возражения с источником ценнее всего: если мы ошиблись, исправим и отметим правку в тексте. Если вы автор ролика и не согласны с разбором, пришлите ответ — опубликуем его здесь же без сокращений.