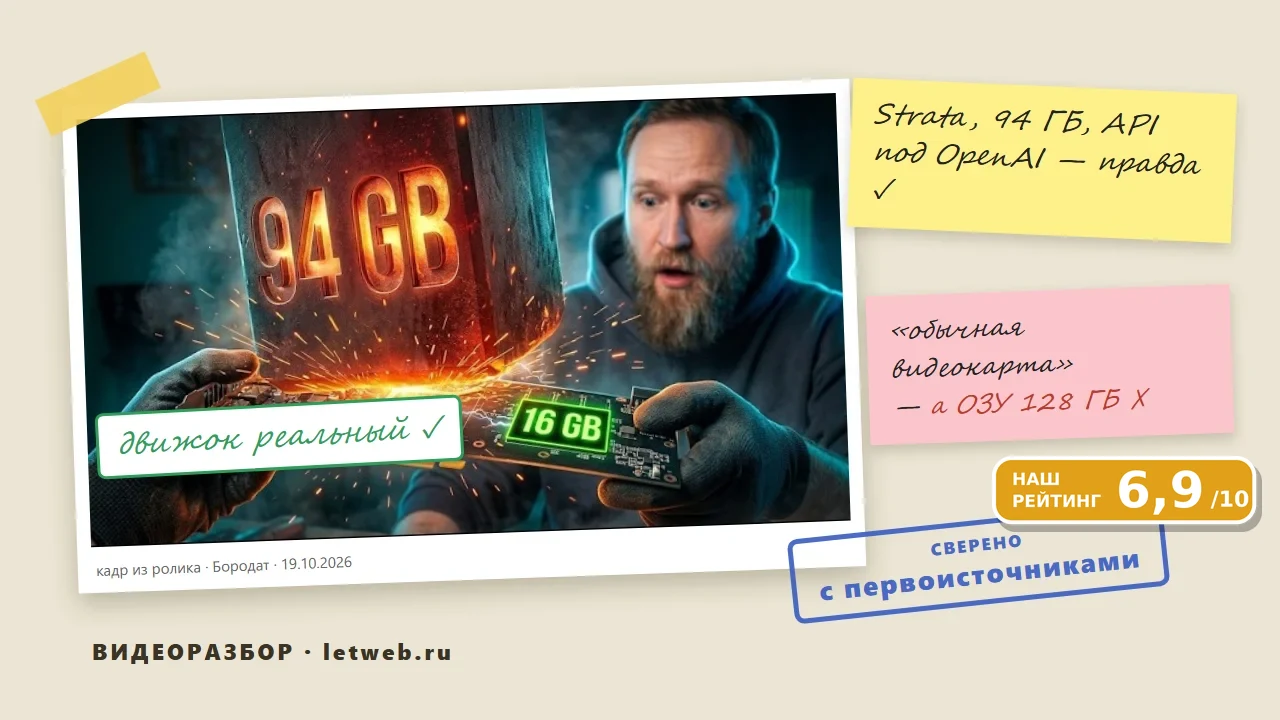
Можно ли запустить Qwen 3.8 локально — не маленькую версию на 27 миллиардов параметров, а флагманскую Qwen3.8-Flash-Next на 125 миллиардов — на домашнем компьютере с одной игровой видеокартой? Блогер Бородат в ролике «Удали Ollama! Этот движок запускает 94 ГБ ИИ на обычной видеокарте» (19 октября 2026 года, 6 минут, больше 126 тысяч просмотров) утверждает, что да: бесплатный движок Strata с GitHub выдаёт больше 60 токенов в секунду на RTX 5080 с 16 ГБ видеопамяти. Мы проверили 16 утверждений из ролика по README проекта, карточке модели на Hugging Face, документации Unsloth и llama.cpp. Вердикт: движок настоящий и цифры похожи на правду, но заголовок умалчивает главное — модель живёт не в видеокарте, а в 128 ГБ оперативной памяти.
- О чём видео
- Qwen3.8-Flash-Next и Strata в цифрах
- Проверка фактов
- Как Strata помещает 94 ГБ в 16 ГБ видеопамяти
- Нейросеть на ПК: сколько нужно оперативной памяти
- Ollama, LM Studio или llama.cpp: правда ли их пора удалять
- Как запустить Qwen 3.8 локально через Strata
- Частые вопросы
- Можно ли запустить Qwen 3.8 Flash Next на 8 ГБ видеопамяти?
- Сколько оперативной памяти нужно для локальной нейросети на 125 млрд параметров?
- Strata быстрее Ollama?
- Это действительно бесплатно и приватно?
- Вывод
О чём видео
Автор объясняет, почему большие модели «не лезут» в домашний ПК, и показывает обходной путь. Обычные программы для локальных нейросетей — Ollama и LM Studio — работают на движке llama.cpp и, по словам автора, при нехватке видеопамяти превращают генерацию в слайд-шоу. Strata, напротив, написана под одну-единственную модель и раскладывает её по видеокарте и оперативке так, что видеокарта не простаивает. Дальше — тесты на длинном промпте и коде, запуск урезанной версии на старой RTX 3060 Ti с 8 ГБ и главный козырь: Strata поднимает на компьютере локальный API, совместимый с OpenAI и Anthropic, — в него можно направить агентов, n8n и среды разработки.
Qwen3.8-Flash-Next и Strata в цифрах
- 125 млрд параметров у языковой части модели, из них на каждый токен работает около 6 млрд.
- 512 экспертов в каждом слое, на токен включаются 10 + 1 общий — около 2%.
- 262 144 токена — родное окно контекста, с YaRN — до миллиона.
- 93,7 ГБ весит квант Unsloth UD-IQ4_XS, который выбрал автор.
- 32 ГБ видеопамяти и оперативки вместе — минимум по README Strata, и то для 2-битных квантов.
- 30 тыс. звёзд у репозитория на GitHub, лицензия MIT.
Проверка фактов
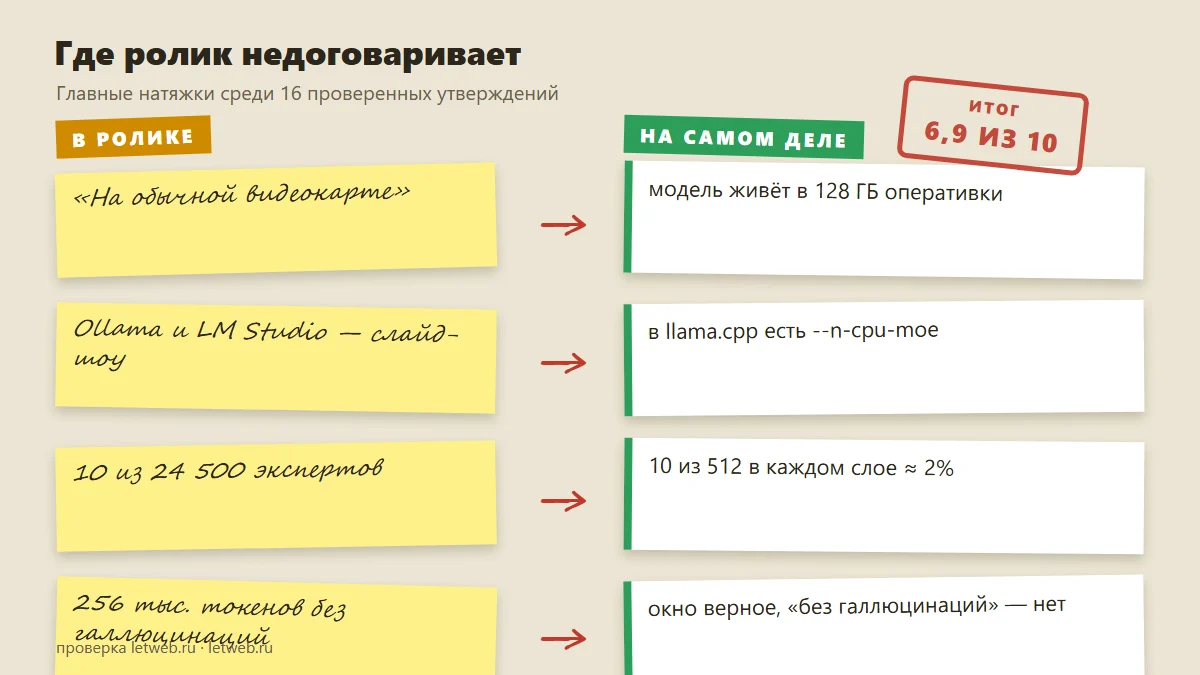
Из 16 утверждений 6 верны полностью, 2 в основном верны, 6 верны частично, 1 вводит в заблуждение и 1 проверить не удалось. Главное — в таблице.
| Утверждение из видео | Вердикт | Чем проверено |
|---|---|---|
| «94 ГБ ИИ на обычной видеокарте» | Вводит в заблуждение | Видеокарта действительно обычная, но вся модель помещается только потому, что у автора 128 ГБ оперативной памяти |
| Strata — бесплатный движок с GitHub, написанный под одну модель | Верно | Репозиторий Niko1221/Strata, лицензия MIT, поддерживается только Qwen3.8-Flash-Next |
| Автор движка — Nika1221, за пару недель больше 20 тыс. звёзд | Верно частично | Ник — Niko1221; сейчас у проекта 30,2 тыс. звёзд, темп роста мы не проверяли |
| Ollama и LM Studio режут модель по слоям, видеокарта стоит в пробке | Верно частично | Так бывает при настройках по умолчанию. Но в llama.cpp есть ключи --n-cpu-moe и --cpu-moe, которые выносят экспертов в оперативку, а внимание оставляют на видеокарте — та же идея, что в Strata |
| Модель на 125 млрд параметров | Верно | Карточка Qwen на Hugging Face; вместе с n-gram-эмбеддингом и модулем MTP набегает около 180 млрд |
| Квант Unsloth UD-IQ4_XS весит 94 ГБ | Верно | Документация Unsloth: 93,7 ГБ |
| По качеству вплотную к полноразмерной модели | В основном верно | Unsloth даёт среднюю KL-дивергенцию 0,084 — заметно ближе к оригиналу, чем 3-битные кванты, но «вплотную» — оценка, а не замер |
| Внутри 24 500 экспертов, на слово включаются 10, работает 2% | Верно частично | Экспертов 512 в каждом слое (≈24 576 всего), на токен работают 10 из 512 в каждом слое. Отсюда и 2%; «10 из 24 500» было бы 0,04% |
| На видеокарте — внимание, роутер и контекст, эксперты — в оперативке | Верно | README Strata: GPU держит постоянную часть и самых частых экспертов, процессор параллельно считает остальных |
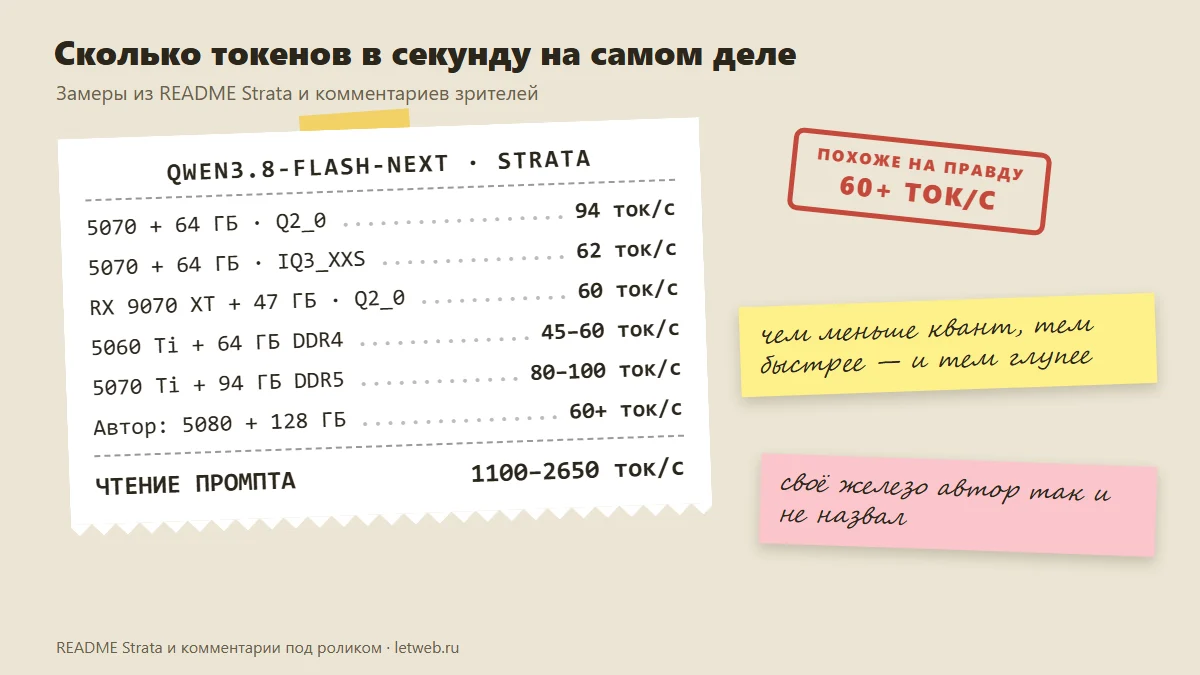
| Больше 60 токенов в секунду на RTX 5080 | В основном верно | В README — 53–94 ток/с на RTX 5070 с 64 ГБ, у зрителей — 45–100. Процессор, тип памяти и PCIe автор не назвал |
| Держит 256 тыс. токенов контекста без галлюцинаций | Верно частично | Окно 262 144 токена — правда. «Без галлюцинаций» ничем не подтверждено |
| Запускается на 3060 Ti с 8 ГБ и 32 ГБ оперативки | Верно частично | Основной README требует NVIDIA от 12 ГБ; 8 ГБ поддерживает форк kstevica/strata. Речь только о самом маленьком кванте |
| Strata поднимает API, совместимый с OpenAI и Anthropic | Верно | OpenAI-совместимый адрес 127.0.0.1:8080/v1, Anthropic API — без /v1, есть Responses API для Codex CLI и MCP-сервер |
| Серверные видеокарты под такую модель стоят около 1,5 млн рублей | Не проверено | Порядок величины правдоподобен, точной сметы нет |
Кроме того, верны: установка одним скриптом START-HERE.bat без сборки, объём видеопамяти RTX 5080 — 16 ГБ.
Как Strata помещает 94 ГБ в 16 ГБ видеопамяти
Qwen3.8-Flash-Next — модель типа MoE, «смесь экспертов». В обычной «плотной» нейросети на каждое слово работают все веса. Здесь в каждом слое сидят 512 небольших подсетей-экспертов, и роутер для каждого токена выбирает 10 из них плюс один общий. В итоге из 125 млрд параметров в каждый момент считаются примерно 6 млрд, а 98% экспертов простаивают.
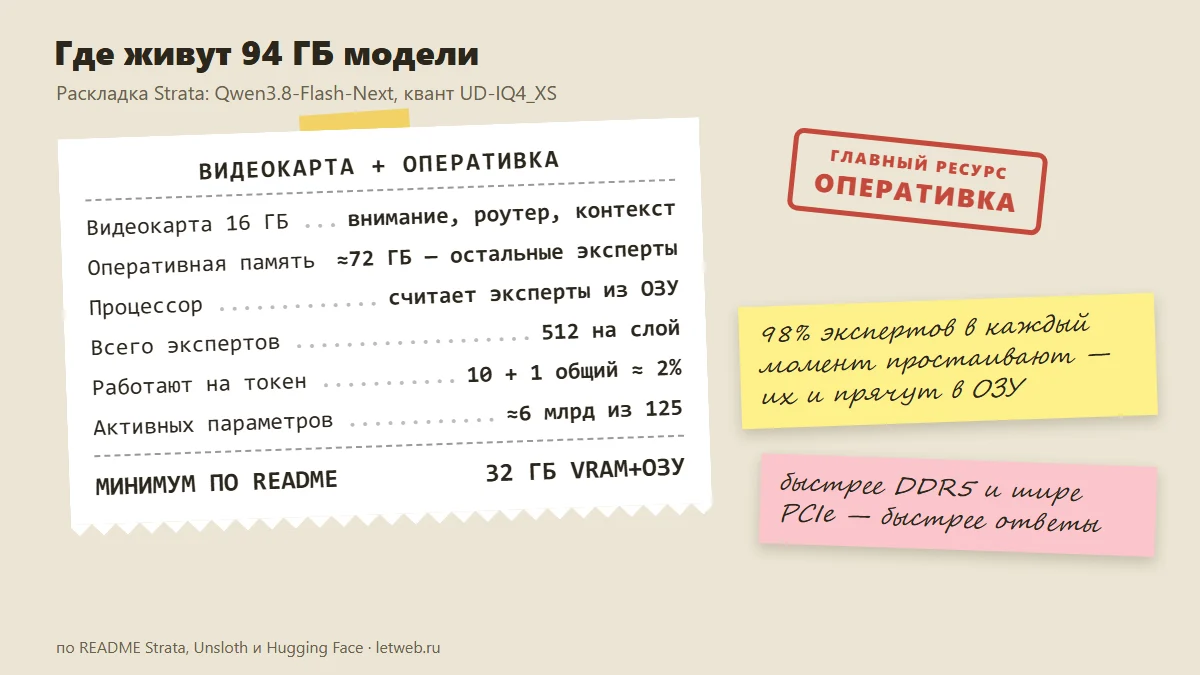
Strata пользуется этим так: в видеопамять кладёт то, что нужно всегда, — механизм внимания, роутер, кеш контекста и самых «популярных» экспертов. Остальные эксперты лежат в оперативной памяти, и процессор считает их одновременно с видеокартой. Через шину PCI Express гоняются не гигабайты весов, а только небольшие промежуточные результаты. Поэтому важны скорость памяти DDR5 против DDR4, число каналов и поколение PCIe — об этом зрители справедливо напомнили автору.
Нейросеть на ПК: сколько нужно оперативной памяти
Главное, о чём молчит заголовок: в этой схеме решающий ресурс — оперативка. Квант на 94 ГБ требует, по README, около 72 ГБ ОЗУ плюс видеопамять, поэтому автору с его 128 ГБ «всё влезло с запасом». На типичных 32 ГБ эта версия не запустится. Ориентиры по README и документации Unsloth:
- IQ2_XS — около 39 ГБ, работает на 12 ГБ видеопамяти и 48 ГБ ОЗУ;
- IQ3_XXS — около 47 ГБ, разумный компромисс для 64 ГБ ОЗУ;
- UD-IQ4_XS — 93,7 ГБ, нужно от 96 до 128 ГБ ОЗУ;
- Q8_0 — около 136 ГБ, это уже уровень рабочей станции.
Чем меньше квант, тем быстрее и тем заметнее модель теряет в качестве. И не забывайте про цены: 128 ГБ DDR5 сейчас стоят сопоставимо с хорошей видеокартой — на это жаловались многие зрители.
Ollama, LM Studio или llama.cpp: правда ли их пора удалять
Нет. Ollama и LM Studio универсальны: в них работают сотни моделей, а Strata — одна. Медленная работа больших MoE-моделей в них — чаще вопрос настроек. В llama.cpp давно есть ключ --n-cpu-moe N: он оставляет на видеокарте всё, кроме весов экспертов первых N слоёв, а эксперты уводит в оперативку. Пользователи рассказывают, как этот ключ поднимал скорость в 2–4 раза, а в октябре 2026 года в llama.cpp появился ещё и кеш экспертов. В LM Studio похожая настройка есть в параметрах выгрузки модели.
Сильная сторона Strata в другом: она «из коробки» подобрана под одну модель, сама проверяет драйверы и предлагает квант под ваше железо. Если вам нужна именно Qwen3.8-Flash-Next и не хочется подбирать ключи — это удобный путь. Если вы уже живёте в Ollama — сначала попробуйте вынести экспертов на процессор там.
Как запустить Qwen 3.8 локально через Strata
- Проверьте железо: видеокарта NVIDIA RTX 20–50 серии от 12 ГБ (поддерживаются также AMD RX 6800 и новее, Intel Arc, Apple Silicon), оперативка — от 32 ГБ вместе с видеопамятью, на диске — около 80 ГБ.
- Скачайте репозиторий Niko1221/Strata с GitHub — напрямую, а не через Telegram-канал, куда автор ролика прячет ссылку.
- На Windows запустите
START-HERE.bat, на Linux и macOS —./setup.sh. Установщик проверит драйверы и предложит квант под ваш объём памяти. - После запуска откроется веб-интерфейс, а по адресу
http://127.0.0.1:8080/v1заработает API в формате OpenAI. Для Claude Code и других клиентов Anthropic адрес тот же, но без/v1; вместо ключа подойдёт любая строка.
Частые вопросы
Можно ли запустить Qwen 3.8 Flash Next на 8 ГБ видеопамяти?
Только через форк kstevica/strata и только самый маленький квант. Основной проект требует от 12 ГБ, а оперативки всё равно нужно много.
Сколько оперативной памяти нужно для локальной нейросети на 125 млрд параметров?
От 48 ГБ для 2-битных квантов, 64 ГБ для 3-битных и 96–128 ГБ для 4-битного UD-IQ4_XS, который показан в ролике.
Strata быстрее Ollama?
При настройках по умолчанию — да, заметно. Но при грамотной выгрузке экспертов в llama.cpp разрыв сокращается; честного сравнения на одном железе автор не показал.
Это действительно бесплатно и приватно?
Да: модель работает на вашем компьютере, токены не стоят ничего, кроме электричества, данные никуда не уходят. Платите вы один раз — за оперативку.
Вывод
Ролик рассказывает о реальном и интересном проекте, и большинство технических утверждений сходится с README Strata и документацией Unsloth. Но подача кликбейтная: «обычная видеокарта» работает лишь в паре с необычными 128 ГБ оперативки, а Ollama и LM Studio вовсе не обречены — им нужна настройка. Если у вас 64 ГБ памяти и карта на 12–16 ГБ, Strata действительно позволит запустить Qwen 3.8 локально с комфортной скоростью — просто с квантом поменьше. Для знакомства с моделью поменьше смотрите наш разбор запуска Qwen 3.8 27B локально.
Плеер YouTube загрузится после нажатия. Не открывается — смотрите ролик на YouTube.
Источники: репозиторий Strata на GitHub, форк kstevica/strata, карточка Qwen3.8-Flash-Next на Hugging Face, документация Unsloth, гайд по выгрузке MoE в llama.cpp, справка llama-server. Проверено 22 октября 2026 года.
Наши оценки
Как считаем. Достоверность — доля подтвердившихся утверждений; ключевые тезисы ролика весят втрое больше второстепенных, мнения не учитываются, а то, что проверить нечем, получает половину. Приём зрителей — доля лайков от просмотров и тон самых заметных комментариев. Итог наполовину состоит из достоверности, на треть — из пользы и на пятую часть — из честности подачи; если заголовок обещает то, чего в ролике нет, снимаем полтора балла, а если ложен главный тезис ролика, итог не поднимается выше 4.
Заголовок и содержание. «На обычной видеокарте» — видеокарта обычная, но нужна 128 ГБ ОЗУ; «Удали Ollama» — Ollama/llama.cpp умеют выносить экспертов в ОЗУ
Реклама и интерес автора. Сервис оплаты зарубежных API (реферальная ссылка), бот для заказа автоматизаций, ссылка на репозиторий спрятана в Telegram-канал
Что пишут зрители
На 22 октября 2026 года: 126 119 просмотров, 3 267 лайков (2,6%), комментариев — 645.
Зрители в основном ловят автора на умолчании: «у него 128 ГБ ОЗУ», «DDR5 128 ГБ стоит как видеокарта», просят указать процессор, тип памяти и PCIe. Есть полезные замеры: 5060 Ti 16 ГБ + 64 ГБ DDR4 на IQ3_XXS — 45–60 ток/с; 5070 Ti + 94 ГБ DDR5 — 80–100 ток/с; напоминание, что важна и скорость префилла. Часть пишет, что в LM Studio то же самое настраивается вручную.
Обсудим?
Сколько оперативки у вас стоит и пробовали ли вы запускать MoE-модели с выносом экспертов в ОЗУ?
Напишите в комментариях под статьёй — что думаете о ролике и о нашей проверке. Возражения с источником ценнее всего: если мы ошиблись, исправим и отметим правку в тексте. Если вы автор ролика и не согласны с разбором, пришлите ответ — опубликуем его здесь же без сокращений.